

Table des matières de l'article :
Par définition, tout serveur web exposé publiquement sur Internet constitue une surface d'attaque. Qu'il s'agisse d'un grand site de commerce électronique, d'une petite API REST, d'un panneau d'administration, d'un point d'accès utilisé par une application mobile ou d'un simple site de démonstration, peu importe : dès qu'un service répond sur un port public, quelqu'un tentera de l'interroger, de l'analyser, de le surcharger ou de l'attaquer.
Il ne s'agit pas d'une possibilité théorique, mais d'une conséquence fréquente de l'exposition sur Internet. Les journaux de tout serveur HTTP public révèlent invariablement la même chose : requêtes vers des chemins inexistants, tentatives d'accès à des fichiers de configuration, analyses automatiques de systèmes de gestion de contenu vulnérables, appels à des points d'accès connus pour WordPress, Joomla, Drupal, Magento, Laravel, phpMyAdmin, les panneaux d'administration, les anciens scripts CGI, les scripts PHP oubliés et les répertoires. .git, fichier .env, des sauvegardes compressées, des dumps SQL et bien plus encore.
Dans le meilleur des cas, si le système est bien configuré et non vulnérable, toutes ces requêtes se soldent par une erreur 404, 403 ou un simple rejet. Mais même en cas d'échec de l'attaque, une action a été entreprise : le serveur a reçu du trafic, ouvert des connexions, consommé des ressources CPU, mémoire, bande passante, E/S, capacité de journalisation et une attention opérationnelle. Autrement dit, même le bruit a un coût.
Le problème du trafic hostile, inutile ou indésirable
La sécurité ne se limite pas au blocage des failles de sécurité. Il s'agit également de réduire l'exposition aux menaces, le bruit opérationnel et la charge générée par toute requête non légitime adressée à un service donné.
Un point de terminaison d'API conçu pour être utilisé exclusivement par une application mobile, une extension Chrome ou un client propriétaire spécifique n'a pas nécessairement besoin de répondre de la même manière à chaque bot, scanner, script Python ou programme Go. curl, un robot d'exploration IA malveillant ou un robot d'exploration générique qui le rencontre lors d'une analyse aléatoire du réseau.
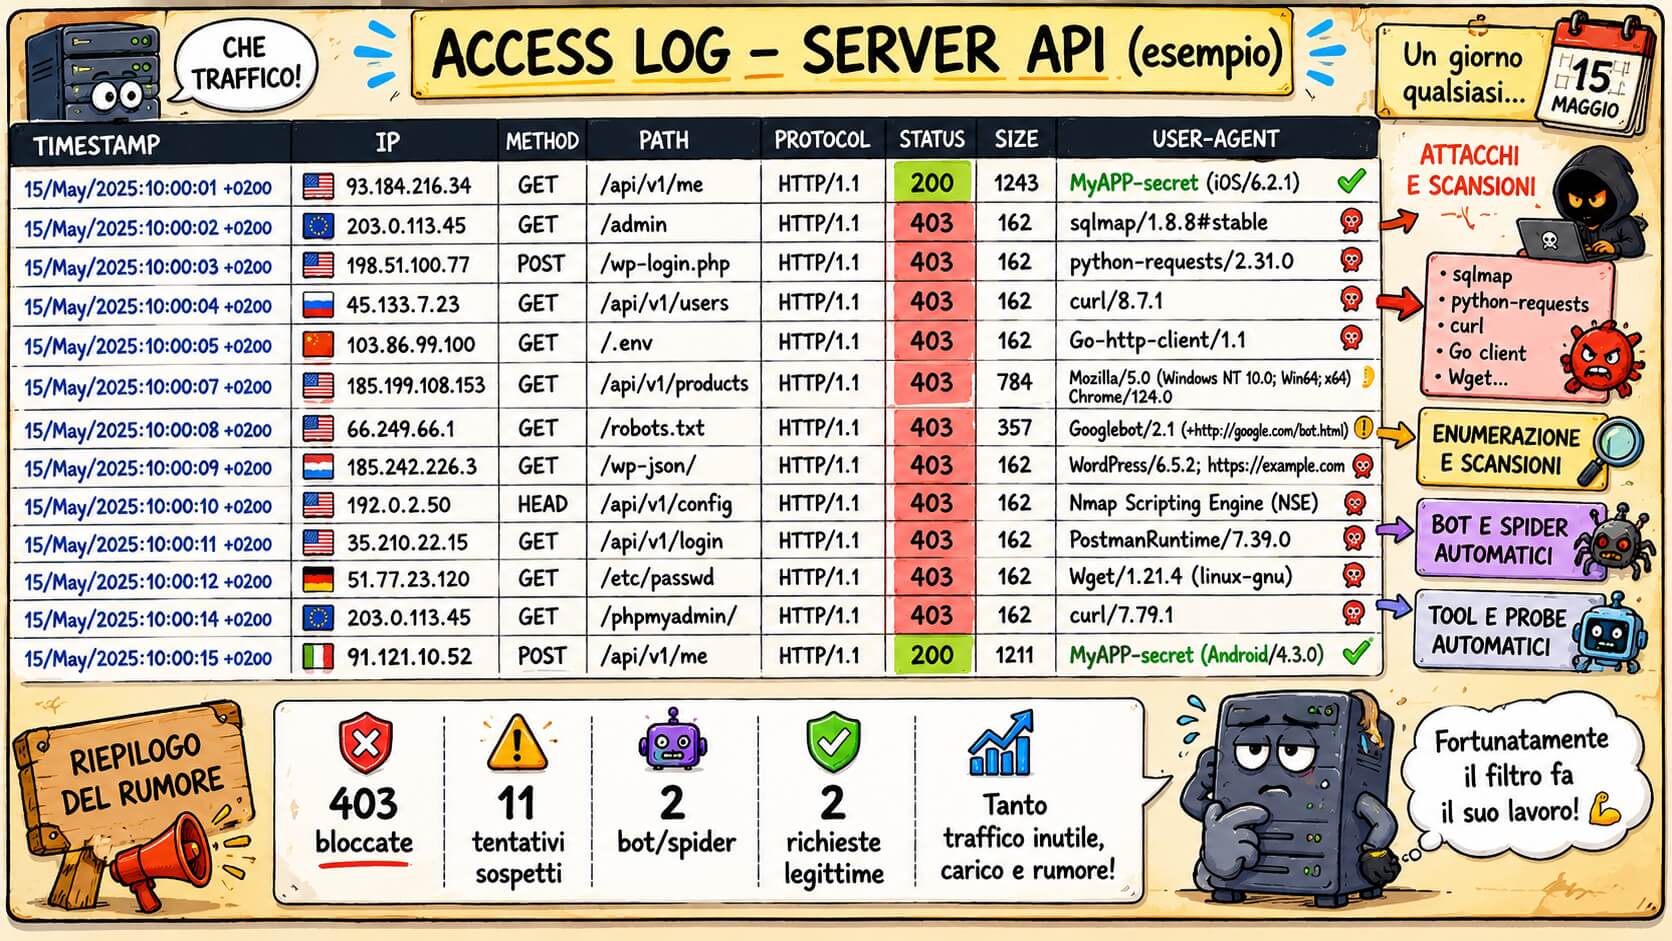
L'objectif n'est pas de se bercer d'illusions en pensant qu'un service public peut être rendu invisible. Si un serveur est accessible via Internet, il peut être détecté. Cependant, il existe de nombreuses nuances entre un service « public et totalement ouvert à toute requête » et un service « privé, protégé par un VPN ou un réseau interne ». L'une d'elles, dans des contextes très spécifiques, est l'utilisation de l' agent utilisateur comme filtre applicatif supplémentaire.
Qu'est-ce qu'un User-Agent ?
L'en-tête User-Agent est un en-tête HTTP envoyé par le client au serveur pour identifier, au moins formellement, le logiciel effectuant la requête. Un navigateur peut se présenter comme Chrome, Firefox, Safari ou Edge. Un bot peut se présenter comme un robot d'exploration. Un script peut se déclarer comme curl, Python-requests, Go-http-client, Java, axios, PostmanRuntime ou toute autre chaîne de caractères.
Il est important de souligner d'emblée un point essentiel : l'agent utilisateur ne constitue pas une identité sécurisée . Il s'agit d'une information déclarée par le client et, de ce fait, elle peut être falsifiée très facilement. N'importe qui peut envoyer une requête HTTP avec l'agent utilisateur de son choix.
Cela ne signifie pas pour autant que l'agent utilisateur est totalement inutile. Cela signifie simplement qu'il ne doit pas être considéré comme une preuve cryptographique d'authenticité. Ce n'est ni un mot de passe, ni un jeton, ni un certificat client, ni une signature numérique. Il s'agit néanmoins d'un signal et, comme tout signal, il peut être utilisé intelligemment dans le cadre d'une stratégie de défense multicouche.
L'idée : n'accepter que des clients connus.
Prenons un exemple concret. Une application iOS, Android ou Chrome spécifique communique avec un serveur distant via une API REST. Ces API ne sont pas conçues pour être librement utilisées par des développeurs tiers ou des utilisateurs lambda. Ce sont des points d'accès dédiés à cette application particulière.
Dans ce scénario, l'application pourrait envoyer un User-Agent personnalisé, par exemple :
MyAPP-secret
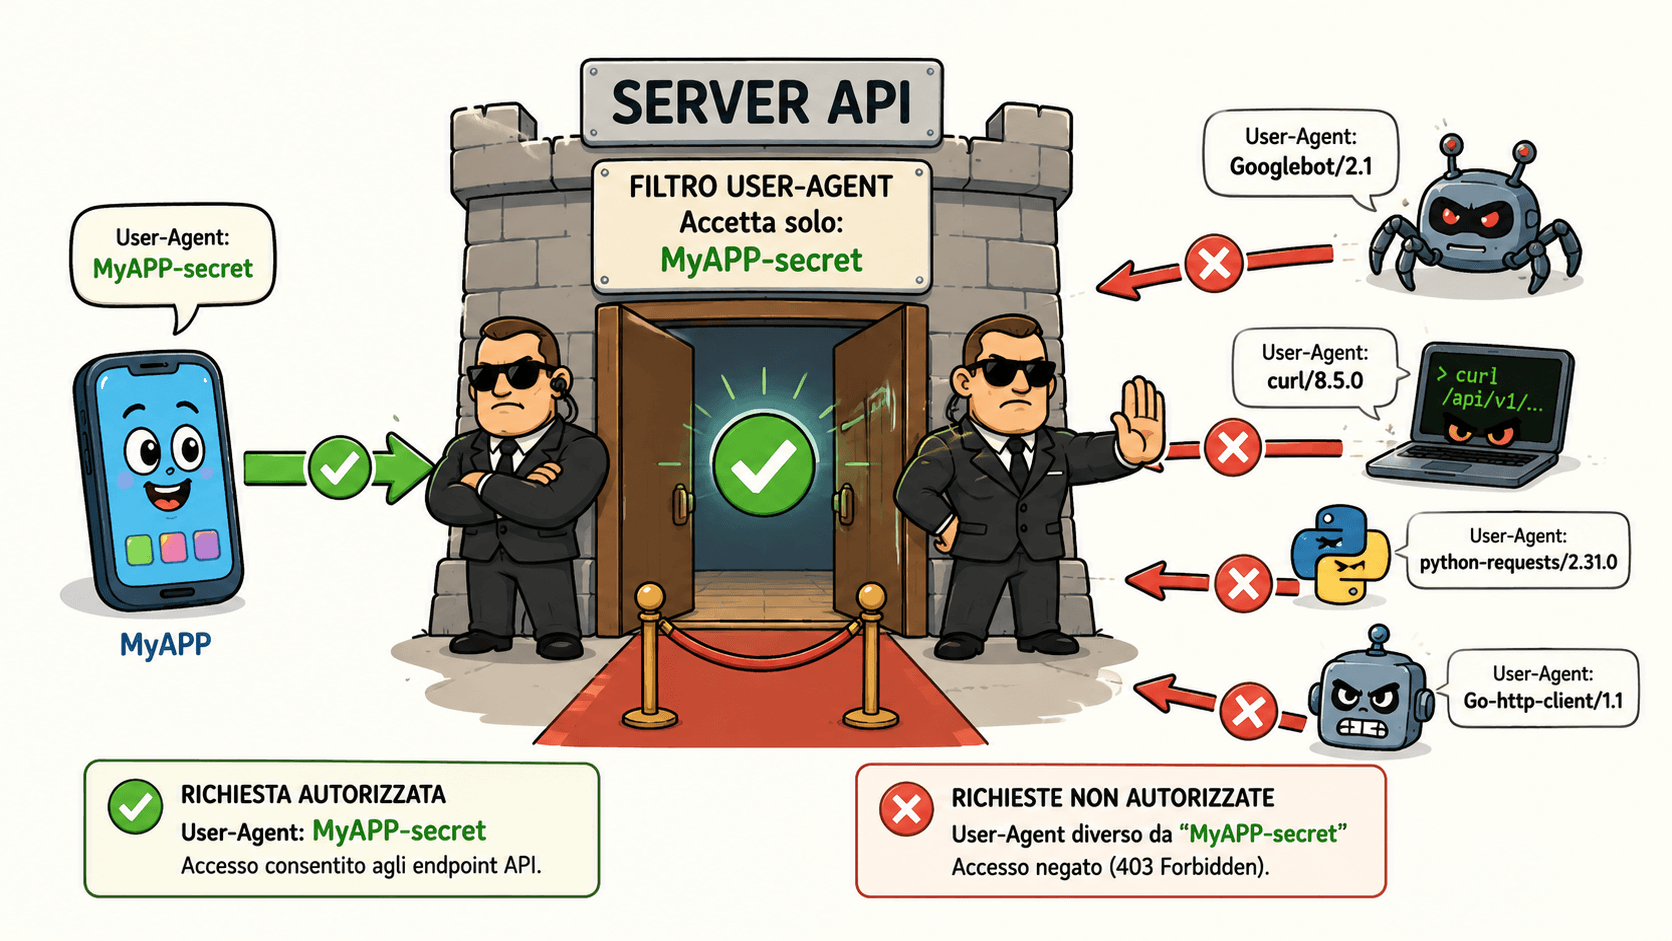
Côté serveur, les points de terminaison de l'API pourraient être configurés pour n'accepter que les requêtes ayant exactement cet User-Agent, rejetant toutes les autres avec un code HTTP 403 Interdit brutal et immédiat.
Le résultat est simple : celui qui arrive avec curlavec Python-requestsavec Go-http-client, avec un scanner automatique ou un agent utilisateur générique, la connexion est coupée avant même d'atteindre la logique applicative la plus coûteuse ou la plus sensible.
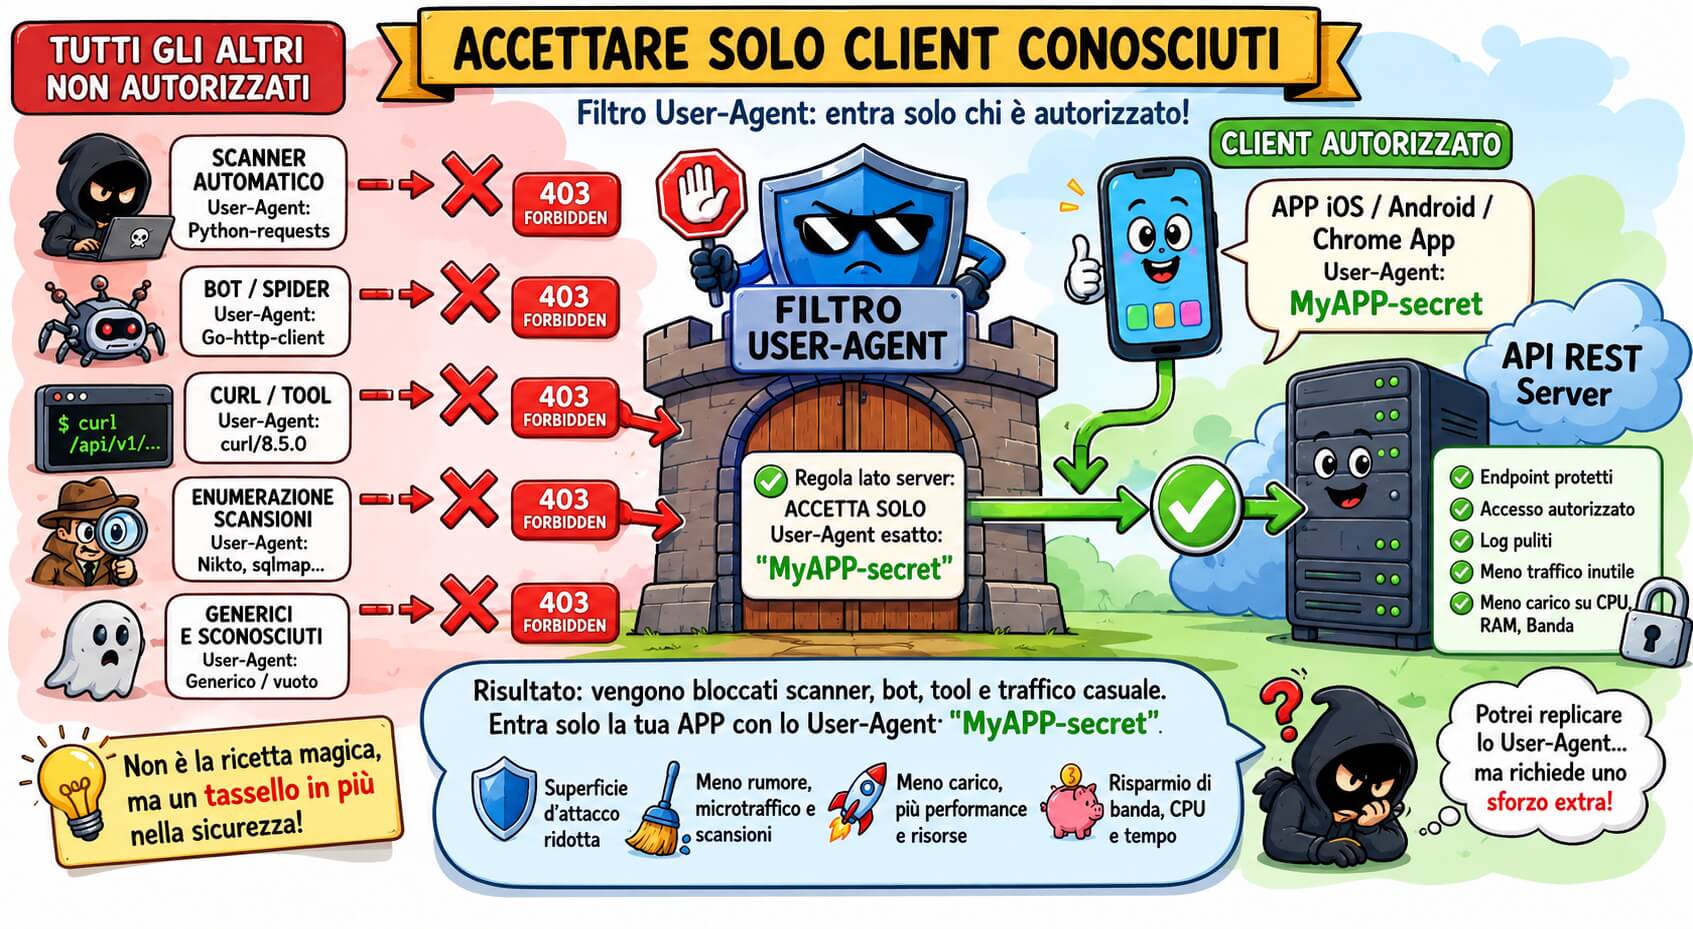
Bien sûr, un attaquant déterminé pourrait analyser le trafic de l'application, le déchiffrer, intercepter les requêtes, observer l'agent utilisateur utilisé et le reproduire. C'est un fait. Mais la sécurité n'est pas toujours une question de tout ou rien entre l'impossible et le trivial. Il s'agit souvent d'augmenter le coût de l'attaque.
De nombreuses attaques sur Internet ne sont ni ciblées, ni manuelles, ni sophistiquées. Ce sont des attaques automatisées à grande échelle. Des scanners testent des millions d'adresses IP. Des bots recherchent des schémas connus. Des scripts tentent d'exploiter des failles courantes. Des outils répertorient les applications vulnérables en se basant sur la loi des grands nombres : tôt ou tard, quelque part, un système réagira mal.
Face à ce type de bruit de fond, un filtre basé sur un agent utilisateur peut avoir un effet pratique significatif.
Ce n'est pas « la » sécurité, mais cela peut en être un élément.
L’essentiel est d’éviter tout malentendu : le contrôle de l’agent utilisateur ne doit jamais être vendu, conçu ou perçu comme une mesure de sécurité principale.
Cela ne remplace pas l'authentification.
Cela ne remplace pas l'autorisation.
Cela ne remplace pas HTTPS.
Il ne remplace pas les clés API, les jetons, HMAC, OAuth, JWT ou mTLS.
Cela ne remplace pas un WAF.
Cela ne remplace pas la limitation de débit.
Cela ne remplace pas une validation correcte des données saisies.
Cela ne remplace pas la journalisation, la surveillance et le renforcement du système.
Mais elle peut constituer un premier niveau de contrôle. Il peut s'agir d'une sorte de « porte extérieure » extrêmement bon marché, conçue non pas pour arrêter un cambrioleur professionnel bien équipé, mais pour empêcher tout passant, robot ou scanner de pénétrer dans la cour et de frapper à toutes les portes intérieures.
En cybersécurité, la superposition de couches est essentielle. Une mesure unique est rarement suffisante. Cependant, la mise en place de plusieurs barrières simples, cohérentes et bien conçues permet de réduire considérablement la surface exposée, le bruit de fond et la probabilité qu'une erreur applicative soit facilement exploitée.
Réduction de la surface d'attaque perçue
Techniquement, le serveur reste public. Par conséquent, la surface d'attaque n'est pas réduite au sens strict, car le point d'accès demeure accessible via le réseau. Toutefois, la surface d'application accessible aux clients non autorisés est réduite.
La différence est importante. Un bot qui envoie une requête aléatoire à /api/v1/users, /login, /admin, /wp-json/, /vendor/phpunit/, /debug, /config, /actuator/env ou d'autres chemins d'énumération typiques peuvent être bloqués en amont, sans passer par toute la chaîne d'applications.
Si la vérification de l'agent utilisateur est implémentée au niveau du serveur web, du proxy inverse ou d'un middleware très léger, la requête peut être rejetée avant d'impliquer PHP-FPM, Node.js, Python, Java, la base de données ou d'autres composants plus coûteux.
Cela signifie une charge CPU réduite, une utilisation de mémoire moindre, moins de requêtes inutiles, moins de journaux d'applications corrompus, moins de fausses alertes, moins de bruit dans les systèmes SIEM et un environnement global plus propre.
Un exemple pratique avec des API REST dédiées
Dans le cas d'une API REST utilisée exclusivement par une application propriétaire, le comportement souhaité peut être très rigide :
- L'agent utilisateur doit être exactement celui attendu ;
- tout autre User-Agent reçoit 403 ;
- Les points de terminaison n'ont pas besoin de fournir de messages d'erreur détaillés ;
- Le contrôle doit avoir lieu dès que possible ;
- Les registres doivent consigner les déchets de manière utile mais pas trop verbeuse.
Par exemple, côté Nginx, vous pouvez définir une règle qui vérifie l'agent utilisateur et bloque toute requête ne correspondant pas à une chaîne attendue. Il est possible de faire de même avec Apache, Varnish, HAProxy, un CDN, un WAF ou directement dans l'application.
Le choix du niveau de blocage dépend de l'architecture. Si l'objectif est d'économiser des ressources, il est judicieux de bloquer le trafic le plus en amont possible. Si vous utilisez un proxy inverse devant l'application, c'est souvent le point idéal. Si vous utilisez un CDN ou un système de périphérie programmable, c'est encore mieux : le trafic indésirable peut être bloqué avant même d'atteindre l'infrastructure d'origine.
Pourquoi cela fonctionne contre de nombreux scanners automatiques
Une grande partie du trafic malveillant ou indésirable repose sur des outils génériques. Ces outils envoient souvent des agents utilisateurs reconnaissables ou ne se donnent même pas la peine de se dissimuler. Certains utilisent des chaînes de caractères standard comme… curl, Wget, Python-requests, Go-http-client, Java, libwww-perl, masscan, sqlmap, nikto, ou des User-Agents complètement vides ou manifestement anormaux.
Bloquer tous les agents utilisateurs, à l'exception d'un ensemble restreint et connu, permet donc d'éliminer une part importante des requêtes inutiles. Non pas parce que le système est devenu invulnérable, mais parce que de nombreux acteurs opportunistes n'ont aucune raison de s'adapter spécifiquement à ce service.
C’est le même principe qui explique pourquoi certaines mesures très simples, bien que non définitives, réduisent considérablement le bruit : désactiver les points de terminaison inutiles, fermer les ports inutilisés, limiter les méthodes HTTP inutiles, empêcher l’affichage des listes de répertoires, bloquer l’accès aux fichiers cachés, appliquer une limitation de débit et utiliser des listes blanches d’adresses IP lorsque cela est possible.
Dans ce contexte, le filtrage par agent utilisateur constitue une mesure supplémentaire.
Les limites : falsifiabilité et maintenance
La principale limitation est évidente : l’agent utilisateur peut être usurpé. Il suffit de connaître la chaîne de caractères correcte et de la reproduire dans la requête. C’est pourquoi il ne faut jamais fonder la sécurité réelle d’une API uniquement sur cette vérification.
Une autre limitation concerne la maintenance. Si l'application change d'agent utilisateur, s'il existe plusieurs versions client, des environnements de test (préproduction, bêta, tests internes), des clients existants ou différentes intégrations, la liste des agents utilisateurs autorisés doit être correctement gérée.
De plus, certaines bibliothèques, certains proxys ou certains composants intermédiaires peuvent modifier ou normaliser les en-têtes HTTP. Il est donc essentiel de tester rigoureusement le comportement réel de l'application en production, et non seulement son comportement théorique.
Il y a ensuite un aspect opérationnel : un filtre trop strict peut bloquer des clients légitimes en cas de bugs, de mises à jour ou de différences entre plateformes. Il est donc conseillé d'introduire ces règles progressivement, en commençant par l'analyse des journaux, en observant les agents utilisateurs réellement utilisés par les clients, et en n'appliquant le blocage qu'ensuite.
Agent utilisateur secret ou identifiant public ?
Dans notre exemple, nous avons utilisé une chaîne de caractères comme MyAPP-secretIl est important de faire une distinction. Si cette chaîne de caractères est considérée comme un véritable secret, il faut garder à l'esprit qu'une application distribuée par l'utilisateur n'est pas un endroit sûr pour stocker des secrets statiques. Un attaquant peut analyser le code binaire, observer le trafic, utiliser un proxy local, procéder à une ingénierie inverse et récupérer la chaîne.
Par conséquent, plutôt que d'être « secret » au sens strict, l'agent utilisateur personnalisé doit être considéré comme un identifiant non public . Il peut être peu connu, non documenté, non standard et utile pour distinguer les clients légitimes du trafic générique. Mais il ne doit pas constituer la seule clé d'accès.
Si une authentification forte est requise, des mécanismes appropriés doivent être utilisés : jetons signés, clés API rotatives, HMAC horodatés, certificats clients, sessions sécurisées, signature des requêtes, vérification des appareils, attestation le cas échéant, et autres solutions conçues pour prouver véritablement l’identité du client.
Une mesure utile, notamment dans les contextes fermés.
Le contrôle de l'agent utilisateur est particulièrement pertinent lorsque le nombre de clients légitimes est limité et prévisible. C'est le cas pour :
- applications mobiles propriétaires ;
- Extensions du navigateur vérifiées ;
- agents logiciels installés sur les systèmes gérés ;
- intégrations privées entre services ;
- API internes exposées publiquement pour des raisons architecturales ;
- points de terminaison techniques utilisés uniquement par une interface spécifique ;
- Services non destinés à être explorés par les navigateurs génériques.
Cependant, cela a moins de sens sur les sites web publics traditionnels, où les utilisateurs peuvent y accéder avec différents navigateurs, versions, appareils, robots légitimes, systèmes d'accessibilité, robots d'exploration des moteurs de recherche et outils. Dans ce cas, un filtre trop restrictif risque de faire plus de mal que de bien.
La règle générale est simple : si l’ensemble des clients légitimes est connu et limité, l’agent utilisateur peut constituer un bon critère de présélection. En revanche, si le service est destiné à être utilisé par tous, le filtrage par agent utilisateur doit être employé avec une grande prudence.
Avantages concrets : réduction de la bande passante, de la charge du processeur et du bruit.
L'un des avantages les plus sous-estimés est la réduction du bruit. Dans la réalité, la circulation indésirable constitue non seulement un problème de sécurité, mais aussi une source de nuisances sonores.
Moins de requêtes inutiles signifient :
- consommation de bande passante réduite ;
- moins de connexions ouvertes ;
- moins de travail en arrière-plan ;
- moins de pression sur PHP-FPM, Node.js, Java ou autres environnements d'exécution ;
- moins de journaux à traiter ;
- moins de fausses alertes ;
- moins de schémas suspects à analyser ;
- Une meilleure distinction entre le trafic légitime et le trafic anormal.
Dans certains cas, notamment sur les terminaux coûteux ou les infrastructures fortement sollicitées, le blocage précoce du trafic indésirable peut avoir un effet notable sur les performances et la stabilité.
Cette mesure ne doit pas être perçue comme une protection miracle, mais plutôt comme un filtre économique. Une requête rejetée avec une erreur 403 au niveau du proxy coûte bien moins cher qu'une requête qui parcourt toute la pile applicative, initialise les frameworks, ouvre des connexions à la base de données et génère des journaux d'application complexes.
Défense à plusieurs niveaux
Une sécurité efficace repose sur une approche multicouche. Le filtrage de l'agent utilisateur peut être combiné à d'autres mesures :
- HTTPS requis ;
- authentification forte ;
- jetons temporaires ;
- signature des demandes ;
- limitation du débit par adresse IP, sous-réseau ou empreinte digitale ;
- géorepérage lorsque cela est pertinent ;
- Liste blanche d'adresses IP pour les environnements contrôlés ;
- WAF avec des règles spécifiques ;
- bloquer les méthodes HTTP inutiles ;
- validation rigoureuse des données d'entrée ;
- journalisation structurée ;
- surveillance des anomalies ;
- alertes en cas de schémas suspects ;
- séparation entre les points de terminaison publics et privés.
Dans ce contexte, le contrôle de l'agent utilisateur constitue un premier filtre. Il ne décide pas lui-même qui est autorisé à accéder aux données, mais élimine rapidement toute personne ne correspondant pas à un client attendu.
conclusion
Utiliser l'agent utilisateur comme mesure de sécurité ne signifie pas croire qu'une chaîne HTTP peut arrêter un attaquant déterminé. Ce serait naïf. Il s'agit plutôt de reconnaître que tout le trafic malveillant n'est pas sophistiqué, que toutes les attaques ne sont pas ciblées et que toutes les requêtes ne méritent pas d'atteindre le cœur de l'application.
Dans certains cas, lorsqu'un serveur expose des API destinées à des clients connus, le filtrage basé sur l'agent utilisateur peut réduire considérablement les analyses, les énumérations, le trafic opportuniste et les perturbations opérationnelles. Il permet d'économiser de la bande passante, des ressources CPU et applicatives, ainsi que du temps d'analyse. Il rend également l'interface de l'application moins accessible aux robots et scanners génériques qui tentent d'accéder au système, espérant trouver une faille.
Ce n'est pas la solution de sécurité ultime. Elle ne doit en aucun cas remplacer l'authentification, l'autorisation, le chiffrement, le renforcement de la sécurité, la limitation du débit et le contrôle des applications. Mais elle peut constituer un élément judicieux d'une stratégie plus globale visant à réduire l'exposition aux menaces.
La sécurité moderne ne se résume pas à des solutions vastes et complexes. Elle repose aussi sur des choix pragmatiques, des filtres ciblés, des barrières successives et une conception architecturale judicieuse. En ce sens, l'agent utilisateur, malgré ses limitations, peut encore jouer un rôle utile : non pas comme une serrure centrale, mais comme un premier point de contrôle pour empêcher l'accès aux personnes non autorisées.

