
Table des matières de l'article :
Le 18 novembre, des milliers de sites web protégés par Cloudflare ont subi des pannes graves et généralisées, donnant l'impression que la moitié d'Internet était hors service . De prime abord, on aurait pu croire à une cyberattaque ou à un problème d'infrastructure global, mais la réalité était bien plus alarmante : une modification des permissions d'une base de données a déclenché un effet domino, provoquant les pannes répétées de l'un des services les plus critiques de Cloudflare. La base de données en question était ClickHouse , une base de données colonnaire haute performance utilisée pour l'analyse en temps réel, choisie pour sa capacité à exécuter des requêtes complexes sur de grands volumes de données en un temps record. C'est une technologie puissante, mais – comme tout composant global et partagé – elle peut devenir une faille de sécurité en cas de modification imprévue.
Que s'est-il passé exactement ?
La gestion des bots Cloudflare repose sur un modèle d'apprentissage automatique qui analyse chaque requête HTTP en évaluant un ensemble de caractéristiques collectées à partir des systèmes internes. Ces caractéristiques sont extraites via une requête sur ClickHouse, puis intégrées à un fichier mis à jour toutes les 5 minutes et distribué sur l'ensemble du réseau mondial Cloudflare. Il s'agit donc d'un mécanisme hautement dynamique et distribué : toute erreur lors de la génération ou de la distribution se propage en quelques minutes.
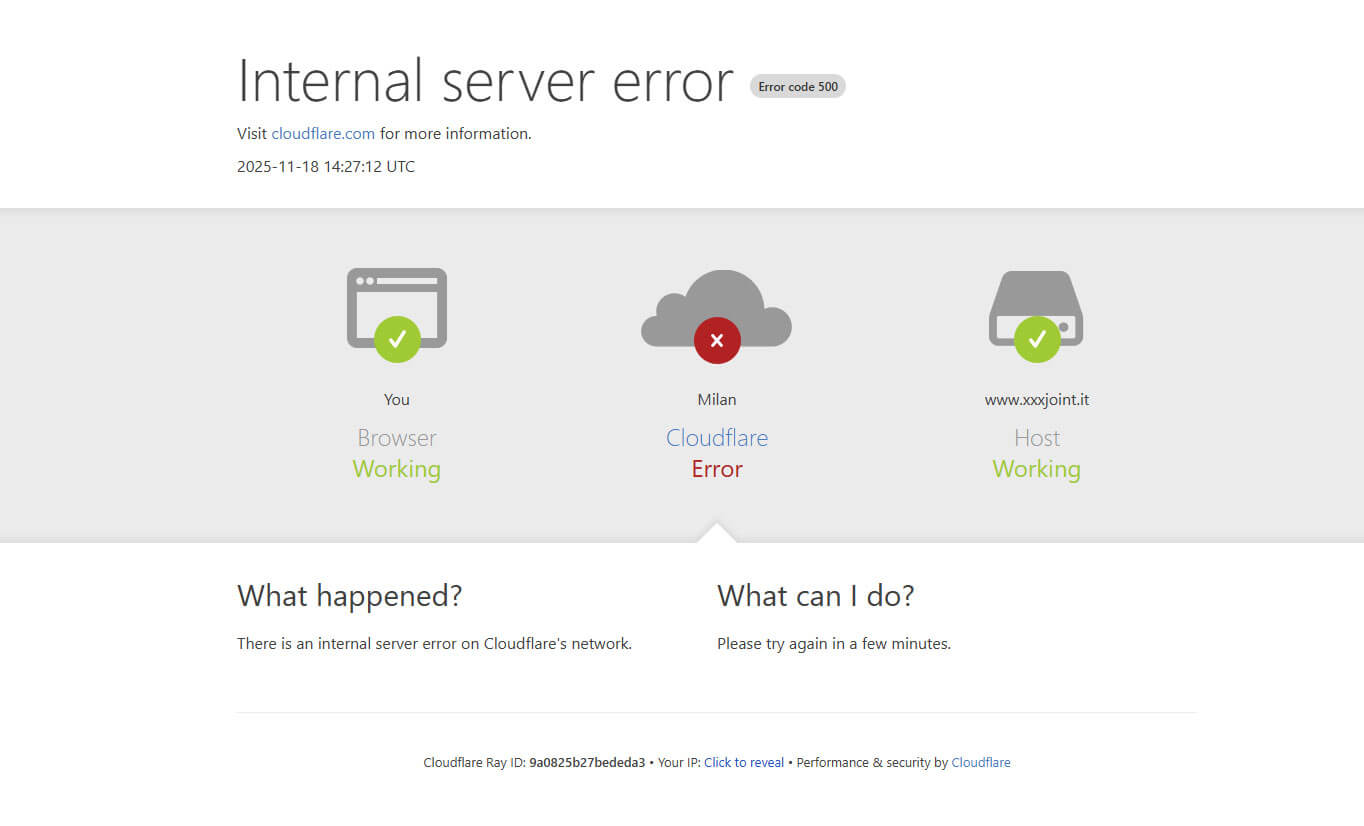
Modification des autorisations de la base de données
L'équipe Cloudflare mettait en œuvre une amélioration de ses processus de sécurité internes : le passage des comptes partagés à des comptes utilisateurs dédiés et à des autorisations explicites. Cette étape impliquait la mise à jour des autorisations sur la base de données ClickHouse utilisée par la gestion des bots. L'opération semblait parfaitement anodine. Personne n'aurait imaginé qu'une modification d'accès puisse altérer le comportement d'une requête fonctionnant depuis des années. Et pourtant, c'est précisément ce qui s'est produit.
L'effet secondaire caché : des données dupliquées
Avant la modification, la requête renvoyait environ 60 entités de la base de données par défaut. Après le changement d'autorisation, ClickHouse a commencé à lire des données non seulement de la base de données « par défaut », mais aussi de la base de données « r0 ». Le résultat : plus de 200 entités . Le module de gestion des bots était limité à 200 éléments . Lorsque la liste a dépassé ce seuil, le service est resté inactif : aucun message d'erreur n'a été enregistré, aucun mécanisme de repli ni de dégradation contrôlée n'a été mis en place . Un problème théoriquement improbable, jamais rencontré auparavant, est soudainement devenu reproductible toutes les cinq minutes, en fonction du nœud générant le fichier d'entités.
Parce que cela ressemblait à une attaque DDoS
Le fichier de configuration était régénéré et redistribué toutes les cinq minutes. De ce fait, certaines instances du réseau Cloudflare recevaient un fichier correct, tandis que d'autres en recevaient un corrompu. Il en résultait un comportement intermittent et erratique : plantages et redémarrages de services, nœuds passant de manière asynchrone en état d'erreur. Ce schéma est également typique d'une attaque DDoS distribuée , en particulier lorsqu'elle affecte plusieurs régions indépendantes. Pour ne rien arranger, la page d'état de Cloudflare est également devenue inaccessible pendant l'incident , en raison d'un problème sans aucun lien avec celui-ci. Une coïncidence fatale qui a induit les ingénieurs en erreur pendant plus de deux heures.
Diagnostic et résolution
Ce n'est que vers 14h30 que l'équipe a identifié la source du problème : un fichier de configuration contenant plus de 200 fonctionnalités, généré par des requêtes modifiées suite à la vérification des autorisations de ClickHouse. Une fois la cause identifiée, les ingénieurs ont stoppé la propagation du fichier défectueux et déployé une version corrigée . Le rétablissement complet a été achevé à 17h06, soit environ deux heures et demie après la correction.
Leçons techniques : ce que les ingénieurs doivent retenir
1. Unwrap() tue les systèmes
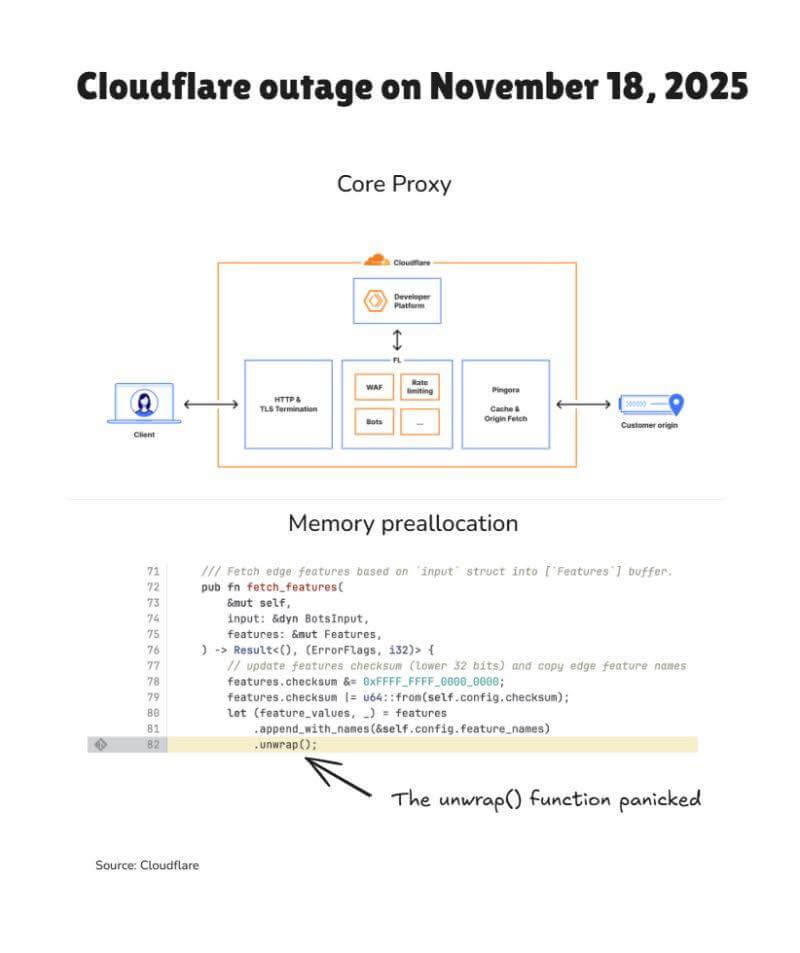
Le problème le plus grave n'était pas le nombre de fonctionnalités, mais la façon dont le logiciel réagissait à l'anomalie. Le module incriminé utilisait .unwrap() En Rust : un choix pratique pour un développement rapide, mais extrêmement dangereux pour les systèmes critiques. La fonction Unwrap() suppose que l'opération réussit toujours. Si quelque chose tourne mal, cela provoque un panique ce qui interrompt l'ensemble du service, sans journalisation, sans contre-mesures, sans diagnostic. Si le système avait consigné un simple message d'erreur au lieu de planter, le problème aurait été identifié en quelques minutes. .unwrap() dans un pipeline mondial peut provoquer un incident international.
2. Les modifications de la base de données globale sont grenades à fragmentation
Une modification des permissions semblait anodine. Mais dans un système complexe et distribué, même ce qui paraît impossible peut engendrer des effets secondaires dans des sous-systèmes sans lien direct avec cette modification. Les environnements de test ne répliquent jamais parfaitement une infrastructure globale. L'idée qu'une simple modification puisse provoquer des résultats de requêtes dupliqués ne figurait pas parmi les risques anticipés. Pourtant, c'est précisément ce qui s'est produit. La leçon est simple : toute modification globale peut engendrer des comportements émergents inattendus.
3. Les coïncidences sont plus trompeurs que les insectes
Lorsque deux problèmes sans lien apparent surviennent simultanément, l'esprit a tendance à créer des associations inexistantes. Le plantage de la gestion des bots et la page d'état hors ligne ont rendu crédible l'hypothèse d'une attaque externe. Cloudflare est quotidiennement la cible de nombreuses tentatives d'attaque : partir de cette hypothèse est donc naturel. Cependant, cela a nécessité 2,5 heures d'investigation pour un problème inexistant. La leçon à retenir : les faits priment toujours sur les explications.
4. Les CDN sont réels point de défaillance unique
Cet incident a mis en lumière une réalité difficile à accepter : Internet est extrêmement dépendant de quelques acteurs mondiaux. Lorsqu'un CDN comme Cloudflare tombe en panne, une grande partie du web est immédiatement impactée. La plupart des entreprises ne disposent ni d'un second CDN opérationnel, ni d'une infrastructure autonome capable d'absorber le trafic. La redondance multi-CDN existe, mais elle est coûteuse, complexe et souvent impraticable. Cette dépendance est bien réelle, et l'incident du 18 novembre l'a une fois de plus démontré.
conclusion
La panne du 18 novembre illustre parfaitement comment des détails apparemment insignifiants peuvent avoir des conséquences désastreuses sur les systèmes mondiaux. Une modification des autorisations de la base de données a altéré le comportement d'une simple requête. Le résultat inattendu a dépassé une limite stricte. Un module critique en dépendait. .unwrap() et a réagi par la panique plutôt que par une gestion de l'erreur. La diffusion mondiale du fichier défectueux toutes les cinq minutes a amplifié l'impact. Un concours de circonstances a entraîné un diagnostic erroné prolongé. Ainsi, à partir d'un simple détail technique, Des dizaines de millions de sites web sont devenus inaccessibles.C’est pourquoi, dans les architectures complexes, ce ne sont pas les attaques qui sont les plus effrayantes : ce sont les petits changements inattendus. Ou pire encore, ce sont les .unwrap() caché dans le code.

