
Table des matières de l'article :
Introduction
Lorsqu'une équipe éditoriale de journal choisit son hébergement WordPress , les questions récurrentes qui guident la décision d'achat sont presque toujours les mêmes :
-
Quelle est la vitesse du site ?
-
Combien d'utilisateurs simultanés peut-il gérer sans s'effondrer ?
-
Quelles sont les garanties de sauvegarde fournies ?
Ce sont là les éléments clés mis en avant dans la quasi-totalité des offres commerciales, car ils représentent les critères immédiats que le client moyen considère comme essentiels. Cependant, en ce qui concerne les journaux en ligne , les besoins vont bien au-delà de la rapidité ou d'une simple infrastructure technique. Le véritable défi consiste à garantir la continuité éditoriale et à préserver le travail quotidien de dizaines de rédacteurs, d'éditeurs et de responsables de publication qui diffusent du contenu en temps réel.
Lors du choix d'un hébergeur, la sauvegarde est souvent perçue comme un système utile uniquement pour restaurer les données en cas de panne matérielle ou de défaillance du fournisseur. Or, l'expérience montre que les problèmes les plus fréquents ne proviennent presque jamais d'un hébergeur réputé, mais des utilisateurs de la plateforme eux-mêmes : administrateurs, rédacteurs et journalistes qui, par inadvertance, peuvent provoquer des dysfonctionnements difficiles à réparer.
Dans cet article, nous allons explorer ces aspects, en commençant par des cas réels d'erreurs humaines dans les rédactions, en passant aux limites des systèmes de sauvegarde actuels, jusqu'à décrire la solution optimale qui rend l'hébergement WordPress dédié à la publication véritablement « à l'épreuve des erreurs humaines » : OpenZFS avec des instantanés instantanés.
Erreurs humaines dans une salle de presse en ligne
Un journal utilisant WordPress n'est pas un simple blog personnel géré par une ou deux personnes. C'est un écosystème complexe, où des dizaines de professionnels travaillent quotidiennement et simultanément sur le même CMS : rédacteurs qui rédigent et publient les articles, éditeurs qui supervisent le flux de contenu, photographes qui mettent en ligne les galeries multimédias, techniciens SEO qui effectuent les optimisations et administrateurs qui gèrent les plugins et les configurations.
Dans un environnement aussi dynamique, où la rapidité est primordiale et où la pression de « publier immédiatement » est constante, les accidents sont inévitables , et bien plus fréquents qu'on ne le pense. Il n'est pas nécessaire d'en arriver à des scénarios extrêmes : un clic involontaire, une mise à jour précipitée ou une procédure suivie superficiellement suffisent parfois à anéantir des heures, des jours, voire des années de travail.
Voici quelques exemples typiques d’erreurs humaines qui peuvent survenir :
-
Suppression involontaire d'articles
Un éditeur sélectionne accidentellement plusieurs éléments de contenu et les supprime de la base de données, pensant corriger les brouillons. En quelques secondes, des articles déjà publiés et indexés disparaissent, avec des conséquences désastreuses pour le référencement et les archives historiques. -
Modifications incorrectes des paramètres critiques
Un administrateur modifie les paramètres des liens permanents pour rendre les URL cohérentes, mais ne remarque pas que des centaines de milliers de liens déjà présents sur Google Actualités et les réseaux sociaux deviennent soudainement inaccessibles. -
Erreurs de plugin ou de thème
Un technicien met rapidement à jour un plugin SEO ou un constructeur de pages sans le tester en phase de test. Résultat ? Une incompatibilité avec la version WordPress ou d'autres plugins, entraînant la perte de données structurées ou le dysfonctionnement de sections entières du site. -
Écrasements massifs
Un éditeur chargé d'importer les données historiques effectue l'opération en production plutôt que dans un environnement de test. En quelques minutes, la base de données est écrasée par les anciennes versions, effaçant les articles et mises à jour récents. -
Suppressions accidentelles d'utilisateurs
D'un simple clic maladroit, un administrateur supprime le compte d'un journaliste de longue date. Dans WordPress, une mauvaise gestion de cette situation peut entraîner la perte ou la dissociation de milliers d'articles produits par cet auteur. -
Téléchargements ou remplacements de fichiers multimédias incorrects
Un photographe télécharge accidentellement un fichier portant le même nom qu'une image déjà utilisée dans des dizaines d'articles. Résultat : d'anciennes images sont écrasées, laissant sur le site des photos incohérentes ou hors contexte. -
Interventions précipitées sous pression
Lors d'un reportage d'actualité, un éditeur tente de corriger rapidement un titre depuis le backend, mais modifie accidentellement le code HTML d'un article entier, effaçant le contenu avec une sauvegarde hâtive.
Pour vous donner une idée, imaginez la rédaction fictive de Quotidiano 24. C'est vendredi soir, et le stagiaire est chargé de supprimer les comptes tests restants dans la base de données. Dans sa précipitation, il sélectionne par erreur le profil du rédacteur en chef, qui travaille là depuis dix ans. D'un clic, il supprime son compte et, avec lui, des milliers d'articles, de galeries photos et autres contenus éditoriaux.
Il n’est pas nécessaire d’imaginer des scénarios apocalyptiques : un moment de distraction, une mise à jour imprévue ou une commande exécutée sans précaution peuvent causer des dommages énormes et potentiellement irréversibles.
Les sauvegardes traditionnelles : une arme contondante contre l’erreur humaine
Les offres d'hébergement classiques proposent aujourd'hui des sauvegardes quotidiennes avec une durée de rétention variable : de quelques jours à plusieurs mois, selon le niveau de service choisi. Les solutions plus avancées offrent des sauvegardes horaires , permettant de remonter jusqu'à une heure avant l'incident. À première vue, cela semble largement suffisant pour de nombreux clients, mais pour un média d'information, la situation est radicalement différente.
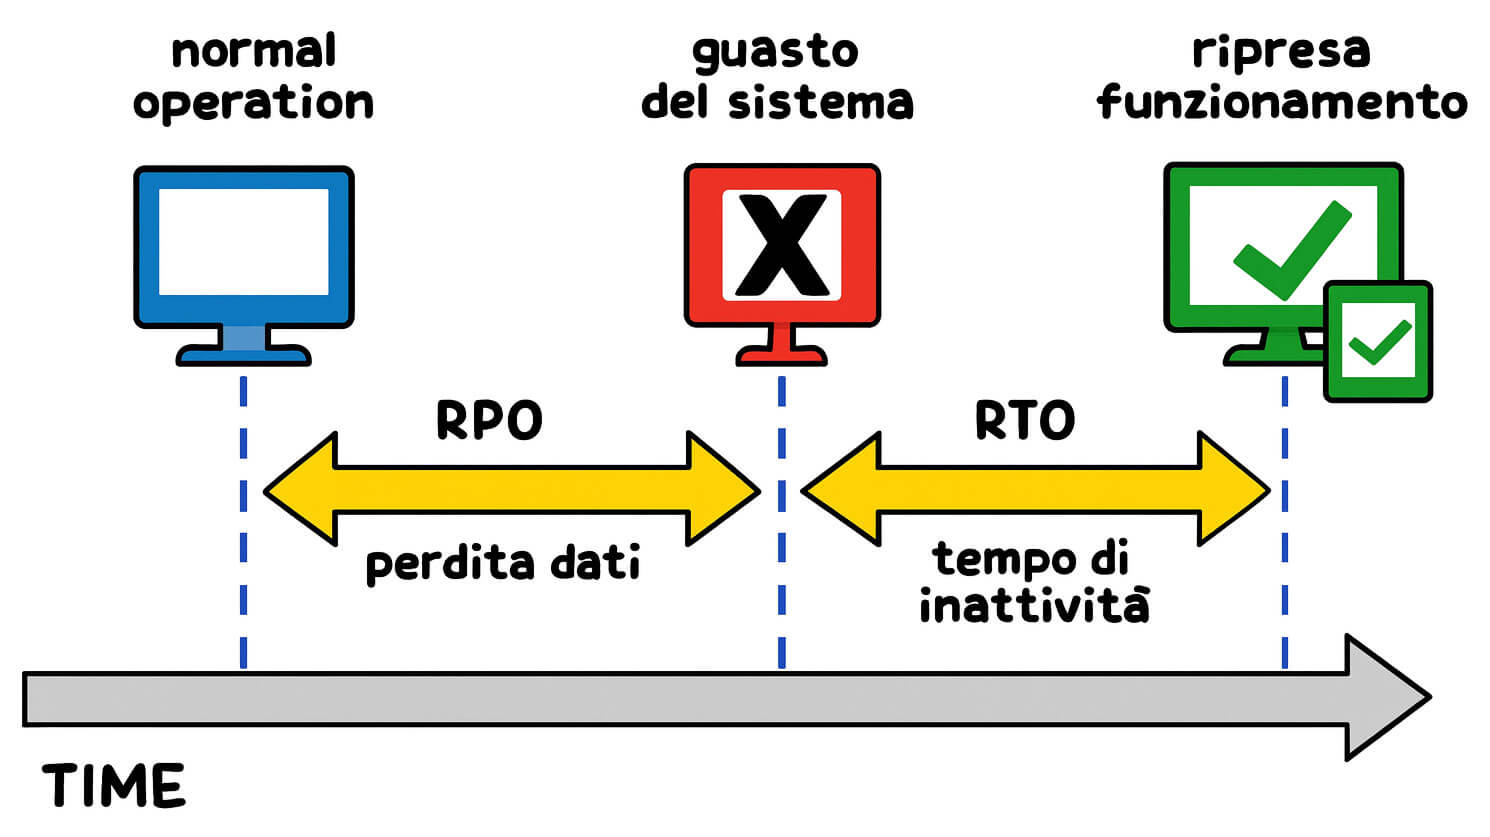
Ici, deux concepts fondamentaux de toute stratégie de continuité des activités entrent en jeu :
-
RPO (Objectif de point de récupération) : indique jusqu’à quelle date je peux remonter pour récupérer des données, c’est-à-dire la quantité de contenu que je suis prêt à perdre en cas de récupération.
-
RTO (Objectif de temps de récupération) : représente le temps nécessaire pour remettre le système en production et le rendre à nouveau opérationnel après une catastrophe.
Dans une rédaction produisant du contenu en continu , un RPO d'une heure est totalement inacceptable. En 60 minutes, un journal en ligne peut publier des dizaines d'articles, diffuser des mises à jour sur l'actualité, enrichir sa page d'accueil de nouvelles galeries photos et diffuser du contenu via Google Actualités et les réseaux sociaux.
Perdre ne serait-ce qu'une demi-heure de travail, c'est anéantir la contribution de toute une équipe éditoriale , avec des conséquences graves : disparition des articles des résultats de recherche, interruption de la couverture de l'actualité en direct, perte de référencement naturel et, surtout, atteinte à votre image et à vos revenus publicitaires. Dans un secteur où la réactivité est primordiale, une heure d'absence équivaut à une perte d'autorité et de confiance, tant auprès des lecteurs que des annonceurs.
Les limites des sauvegardes incrémentielles traditionnelles
Des outils plus sophistiqués existent, tels que Percona XtraBackup ou son dérivé MariaBackup , qui permettent d'effectuer des sauvegardes incrémentales . Cette approche réduit considérablement le temps de génération des sauvegardes ainsi que l'espace disque occupé, puisque seule la différence avec la sauvegarde précédente est enregistrée. En théorie, en programmant des sauvegardes incrémentales toutes les 5 minutes, il est possible d'atteindre un RPO extrêmement faible , quasi idéal pour une équipe éditoriale qui ne peut se permettre de perdre la moindre quantité de contenu.
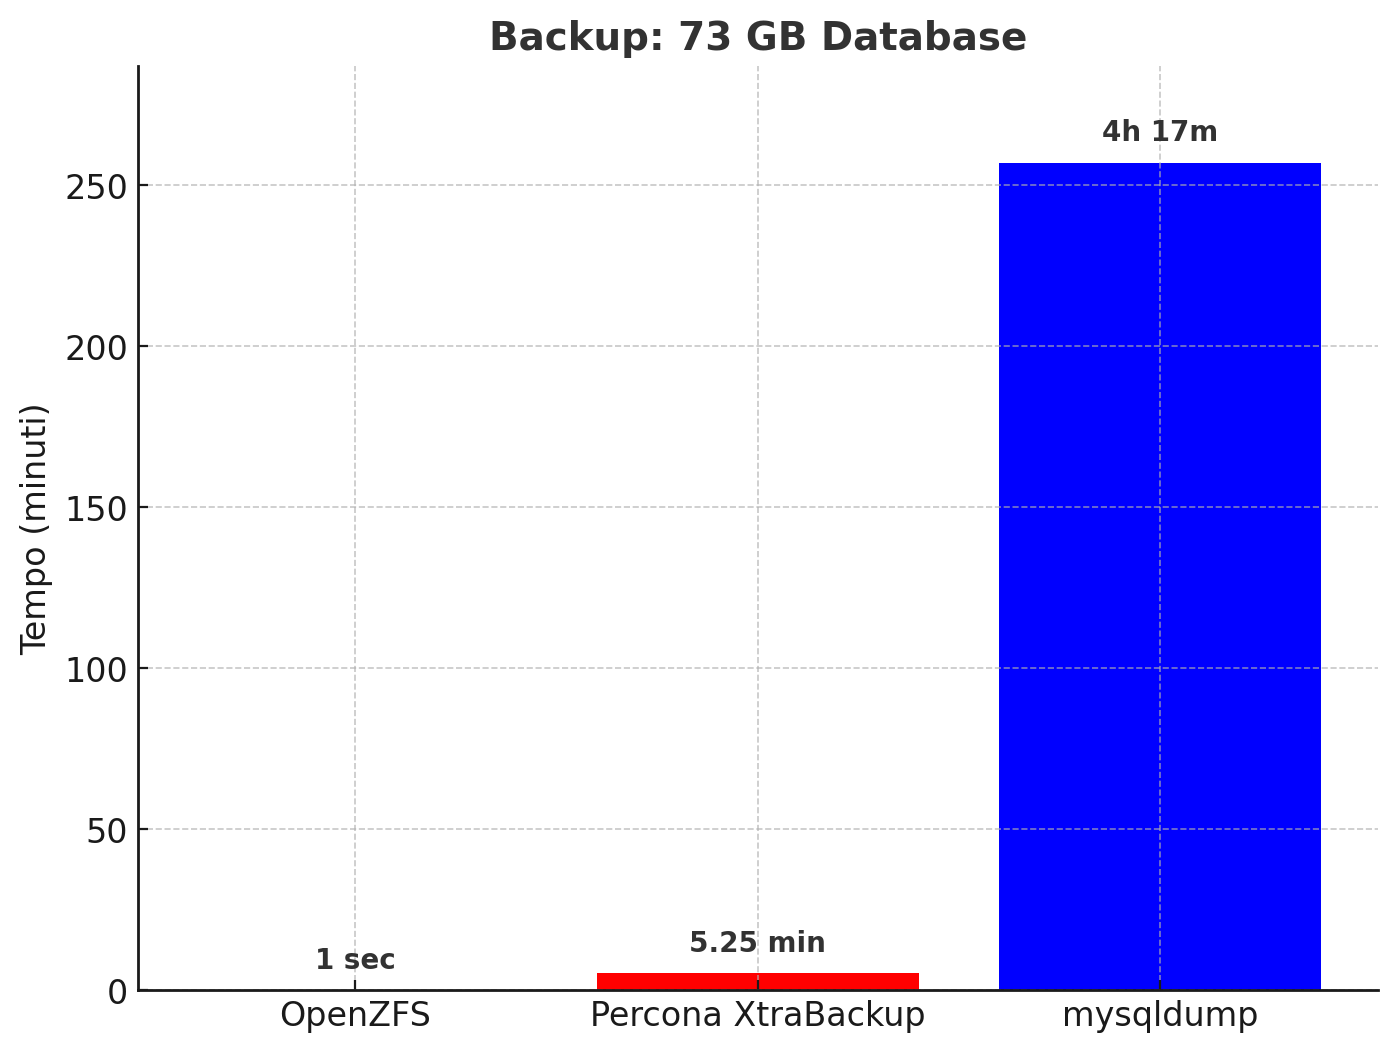
La pratique, cependant, raconte une histoire très différente :
-
Le processus de récupération est complexe et long. Restaurer une base de données à son état souhaité nécessite plus d'un simple clic : il faut d'abord décompresser l'intégralité de la sauvegarde complète, puis appliquer une à une, de manière séquentielle, toutes les sauvegardes incrémentales jusqu'au point choisi dans le temps.
-
Le nombre de sauvegardes incrémentales croît de façon exponentielle. Avec des instantanés programmés toutes les 5 minutes, des centaines de sauvegardes s'accumulent en une seule journée. Leur traitement prend des heures, ce qui a un impact considérable sur les temps de récupération.
-
L'intervalle de temps de récupération (RTO) augmente considérablement. Bien que l'intervalle de temps de récupération (RPO) soit excellent sur le papier (quelques minutes seulement), en réalité, le temps nécessaire pour remettre l'environnement en production rend cet avantage théorique pratiquement inutile.
-
Les très grands volumes de données compliquent la situation. Lorsqu'il s'agit de bases de données de plusieurs centaines de gigaoctets — un cas fréquent pour un média archivant des années d'articles, de contenus multimédias et de commentaires — la génération d'une sauvegarde incrémentale peut prendre plus de 5 minutes, le cycle prévu. Autrement dit, le système risque de ne pas pouvoir supporter la charge.
Le résultat est paradoxal : une technologie censée garantir une sécurité maximale risque en réalité de créer une fausse impression de sécurité . Lors de la conception d’une stratégie de sauvegarde, nous nous concentrons presque exclusivement sur l’ objectif de point de restauration (RPO) , sans évaluer pleinement le délai de restauration (RTO) réel au moment critique de la restauration. C’est précisément à ce moment-là que nous réalisons que nous disposons d’un système apparemment efficace, mais incapable de restaurer les opérations dans les délais requis par un environnement de publication qui privilégie l’immédiateté.
La phase dite de « préparation » , typique des systèmes comme Percona XtraBackup ou MariaBackup , complexifie encore davantage le processus . Après une sauvegarde, les données ne sont pas immédiatement utilisables : elles doivent être préparées . Cette phase consiste à appliquer les journaux de restauration et les journaux de transactions à la sauvegarde afin de rétablir la cohérence de la base de données. Autrement dit, la préparation transforme une copie brute des fichiers InnoDB en une sauvegarde véritablement restaurable.
Le problème, c'est que cette opération, en apparence transparente, est en réalité très coûteuse en temps et en ressources. Plus le volume de données est important et plus les étapes à appliquer sont nombreuses, plus le processus de préparation sera long. Dans le pire des cas, il peut falloir attendre des heures avant de disposer d'une sauvegarde opérationnelle , annulant ainsi les avantages promis d'un RPO réduit. En pratique, disposer des données ne suffit pas : il faut attendre la fin du processus de préparation pour qu'elles soient effectivement disponibles, ce qui allonge encore le RTO dans les situations où une restauration rapide est essentielle.
La solution : OpenZFS et les instantanés instantanés
C’est là qu’intervient ZFS , dans sa variante open source OpenZFS . Conçu à l’origine pour les environnements d’entreprise et dédié à la gestion avancée de l’intégrité des données et au stockage à grande échelle, ZFS est aujourd’hui adopté dans des secteurs critiques tels que la banque et la finance, où toute perte de données est inacceptable. C’est précisément pour ces raisons qu’il constitue une solution idéale pour l’hébergement WordPress destiné aux journaux , qui doivent garantir une continuité éditoriale sans faille.
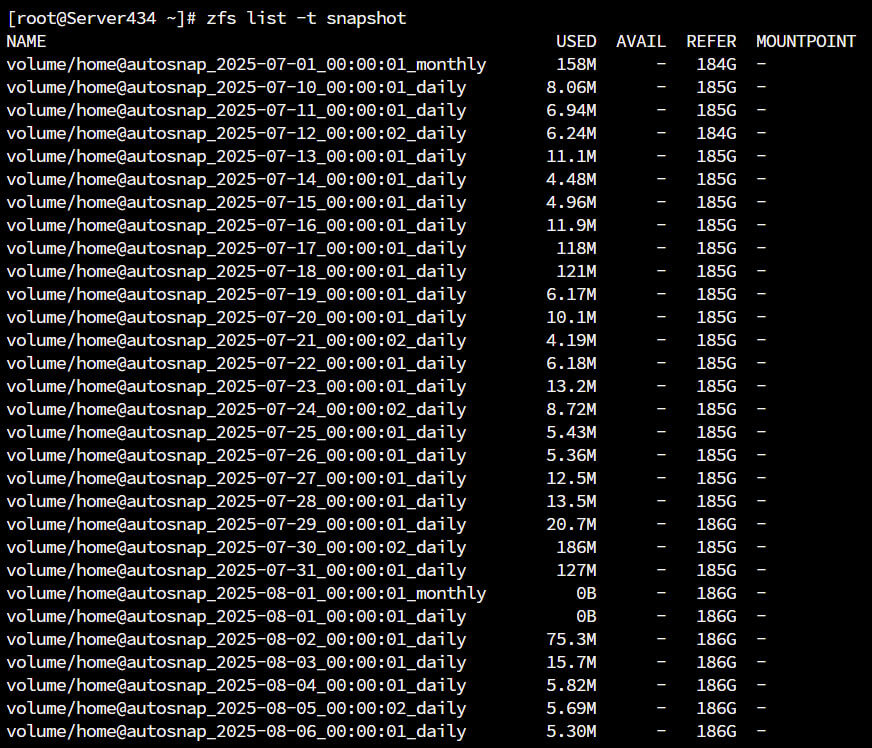
Son atout majeur est la fonctionnalité Instant Snapshots , une approche totalement différente des sauvegardes traditionnelles ou incrémentales.
-
Vitesse réelle, pas théorique. La création d'un instantané ZFS prend moins d'une seconde : le temps varie généralement entre 100 et 500 millisecondes , quelle que soit la taille des données. Qu'il s'agisse de quelques gigaoctets ou de centaines, l'opération est instantanée.
-
Optimisation de l'espace. Les instantanés ne dupliquent pas les données : ils enregistrent uniquement les différences par rapport à l'état précédent, minimisant ainsi l'espace de stockage nécessaire. Par conséquent, même une politique d'instantanés très fréquente (toutes les quelques minutes) reste économe en ressources.
-
Granularité flexible. Les instantanés peuvent être programmés à des fréquences impensables pour d'autres systèmes : toutes les 5, 3 ou même 2 minutes , sans impacter les performances opérationnelles du site ni surcharger le serveur.
-
Restauration instantanée. Chaque instantané peut servir de point de restauration indépendant : inutile d’appliquer des chaînes de restauration incrémentales ni de décompresser d’énormes archives. Le temps de restauration est ainsi réduit à quelques secondes , ce qui rend le système totalement infaillible.
En d’autres termes, OpenZFS permet à un organisme de presse en ligne d’être sûr que toute erreur, de la suppression d’un seul article à une catastrophe plus importante, peut être traitée rapidement, de manière sélective et sans interruption.
Scénarios pratiques en salle de rédaction
-
Récupération sélective sans temps d'arrêt
À 11h45, vous réalisez qu'un article a été supprimé par inadvertance par un éditeur. Grâce à ZFS, vous montez l'instantané de 11h40 sur un point de montage virtuel, exportez le contenu de la base de données de cet article et l'importez directement sur le site de production. Tout cela se produit sans jamais interrompre le portail, qui continue d'engendrer du trafic et des visites. -
Restauration instantanée d'un système entier
À 11h42, l'ordinateur portable du rédacteur, chauffé à blanc, est choisi comme lit par le chat de la rédaction. Accroupi, le chat appuie sur une combinaison de touches et supprime l'utilisateur. Pauline Donald Duck Avec ses 13 000 articles, un simple clic vous permet de revenir à l'instantané de 11 h 30, de réinitialiser la base de données 12 minutes plus tôt et de récupérer instantanément tout le contenu perdu. -
Clonage à coût nul
Les snapshots peuvent être clonés et montés dans des environnements parallèles sans occuper d'espace supplémentaire. Cela vous permet de tester les procédures de récupération, d'analyser les erreurs ou de récupérer des éléments de contenu individuels dans un environnement isolé, sans risque pour le site en production. -
Testez les mises à jour sans risque
L'équipe éditoriale souhaite mettre à jour WordPress vers la dernière version majeure, mais craint une incompatibilité avec les extensions ou le thème personnalisé développé en interne. Elle crée alors un clone instantané de la version de production et le monte comme environnement de test, identique en tous points. Cela lui permet de tester la mise à jour et de s'assurer de son bon fonctionnement avant de l'appliquer au site principal. -
Récupération granulaire des supports et des pièces jointes
Un photographe télécharge un fichier multimédia portant le même nom qu'une image déjà présente dans la bibliothèque, l'écrasant ainsi. L'instantané 11:10 est monté, le fichier remplacé est récupéré et réinséré dans la bibliothèque WordPress. Pas de restauration complète du système, mais une récupération rapide et précise. -
Protection contre les modifications incorrectes massives
Un responsable SEO exécute accidentellement un script qui modifie des centaines de balises méta et de titres. Un instantané pris quelques minutes plus tôt permet au responsable du site de comparer rapidement les versions et de restaurer le contenu d'origine, sans compromettre son indexation.
Pourquoi ZFS est différent des sauvegardes incrémentielles
La principale différence réside dans le fait que chaque instantané ZFS est autonome et immédiatement utilisable , sans qu'il soit nécessaire de reconstruire des chaînes de sauvegarde incrémentielles ni de décompresser d'énormes archives. Ainsi, alors qu'avec les systèmes traditionnels la restauration peut nécessiter des heures de travail d'ingénierie, avec ZFS, le temps de restauration se mesure en secondes , quelle que soit la taille de la base de données ou le nombre d'articles publiés.
En pratique, il ne s'agit plus d'un processus complexe et fastidieux, mais d'une simple opération de montage ou de restauration, rapide et sécurisée. Cela transforme radicalement la gestion des sauvegardes pour une rédaction.
Les avantages sont clairs :
-
L'objectif de point de récupération (RPO) est réduit à quelques minutes seulement. Grâce à la possibilité de programmer des instantanés extrêmement fréquents (même toutes les 2 à 5 minutes), la quantité maximale de données que vous risquez de perdre en cas d'incident est réduite à un minimum vital.
-
Le délai de restauration est réduit à quelques secondes. Chaque instantané est prêt à l'emploi et peut être monté immédiatement. Que vous restauriez un seul article, une table entière ou la base de données complète, votre site est de nouveau opérationnel en un temps record.
-
Granularité de la récupération. Plus besoin de choisir entre « tout perdre » et « tout restaurer » : vous pouvez agir de manière ciblée, en récupérant uniquement ce dont vous avez besoin, d’un simple fichier à un système entier.
Cette combinaison – un RPO de quelques minutes et un RTO de quelques secondes – offre une garantie imbattable aux publications en ligne qui doivent assurer une continuité éditoriale 24 h/24 et 7 j/7. Dans un secteur où l'information circule à la vitesse des réseaux sociaux et où chaque minute perdue peut se traduire par des milliers de visites manquées, la différence n'est pas seulement technique : elle est stratégique et concurrentielle.
Limitations actuelles du marché de l'hébergement WordPress
Malgré ses avantages évidents, l'adoption de ZFS dans les environnements d'hébergement WordPress reste relativement rare. La plupart des fournisseurs continuent de privilégier les sauvegardes horaires ou les systèmes incrémentaux traditionnels : des solutions « efficaces, mais pas optimales », dont les limites se révèlent particulièrement lorsque les volumes de données deviennent importants et que la gestion de la conservation devient complexe.
Les raisons de cette faible diffusion sont principalement de trois ordres :
-
Manque d'expertise interne. La gestion de ZFS est complexe : elle exige une connaissance approfondie du stockage, des systèmes de fichiers et des systèmes UNIX. Toutes les équipes techniques ne possèdent pas ces compétences, et l'adoption peut s'avérer plus un frein qu'une opportunité.
-
Coûts d'infrastructure. La mise en œuvre de ZFS en environnement d'entreprise exige des serveurs dotés de ressources et d'un espace de stockage adaptés, capables de gérer des instantanés fréquents et des volumes de données très importants. Or, tous les fournisseurs ne sont pas disposés à investir dans ce type d'infrastructure pour le marché de l'édition en ligne, où le prix le plus bas est souvent privilégié.
-
Un esprit conservateur. Nombre de fournisseurs préfèrent s'en tenir aux technologies éprouvées, comme les sauvegardes incrémentales traditionnelles ou les solutions basées sur rsync, même si elles sont moins performantes. La crainte d'introduire de la complexité ou de devoir former le personnel les conduit à rejeter d'emblée les alternatives plus innovantes.
À cela s'ajoute un aspect historico-technique : ZFS a été initialement développé par Sun Microsystems et distribué sous licence CDDL (Common Development and Distribution License) . Après le rachat de Sun par Oracle, le projet a été poursuivi par la communauté open source dans sa variante OpenZFS . Cependant, du fait même de la licence CDDL, ZFS ne peut être directement intégré au noyau Linux, ce qui implique que son implémentation requiert un minimum de tact et d'expérimentation de la part de l'administrateur système.
Cela crée un autre obstacle : installer un package standard ne suffit pas ; il faut configurer, tester et comprendre parfaitement la logique de ZFS. Cependant, une fois qu'un technicien se familiarise avec ses fonctionnalités (instantanés instantanés, clonage gratuit, gestion avancée de l'intégrité des données), il devient difficile de revenir aux systèmes traditionnels.
Conclusions
L'hébergement WordPress pour un journal en ligne ne peut se contenter de promettre vitesse et évolutivité. Ces facteurs sont importants, certes, mais ils ne représentent qu'une infime partie des enjeux. Une rédaction numérique moderne est confrontée à une réalité plus complexe : la nécessité de garantir la continuité éditoriale non seulement des pannes matérielles ou des dysfonctionnements du fournisseur, mais surtout du facteur humain , qui demeure la principale cause d'incidents et de dysfonctionnements opérationnels.
Les sauvegardes traditionnelles , même celles qualifiées d’« avancées » car effectuées toutes les heures, sont insuffisantes dans un contexte où une heure de production équivaut à des dizaines d’articles , souvent déjà publiés et indexés sur Google Actualités, et donc susceptibles de générer des milliers de vues en quelques minutes. Dans ces situations, perdre ne serait-ce qu’une demi-heure de travail revient à anéantir la contribution de toute une équipe éditoriale, avec des conséquences financières et réputationnelles difficiles à quantifier.
Les technologies de sauvegarde incrémentale , bien que plus sophistiquées, risquent de se révéler un piège technique : elles promettent des RPO réduits, mais se heurtent à des RTO insoutenables . Lorsque survient le moment critique de la restauration, il devient évident que les heures nécessaires à l’application de centaines de sauvegardes incrémentales rendent impossible une remise en ligne dans les délais imposés par le cycle d’information numérique, souvent très court.
La véritable révolution réside dans OpenZFS et ses instantanés . Grâce à cette technologie, l'approche change radicalement :
-
les sauvegardes peuvent être planifiées avec une granularité de quelques minutes ;
-
les restaurations se produisent en quelques secondes, pas en heures ;
-
Vous pouvez cloner des environnements entiers de manière transparente, tester des procédures ou récupérer de manière sélective des contenus individuels.
Il ne s'agit pas d'une promesse futuriste, mais d'une réalité bien ancrée dans les secteurs les plus critiques : la finance, les télécommunications, le stockage d'entreprise et les centres de données stratégiques , où toute perte de données ou interruption de service est inacceptable. Le plus surprenant est que cette technologie, pourtant si mature et performante, reste si limitée pour l'hébergement WordPress, alors qu'elle est parfaitement adaptée aux problématiques concrètes de la publication en ligne.
Dans un monde où les médias doivent garantir à leurs lecteurs une continuité, une résilience et une réactivité absolues , la voie à suivre est claire : abandonner les modèles traditionnels et adopter des outils véritablement efficaces. L’ hébergement WordPress idéal pour une rédaction numérique, « à l’épreuve des erreurs humaines », ne peut ignorer la mise en œuvre de ZFS. Une fois que vous aurez expérimenté la puissance des snapshots et la facilité avec laquelle vous pouvez vous remettre de n’importe quel incident, il vous sera difficile de revenir en arrière.

